AI 记住了你,为什么还是不够懂你?
长期记忆如何成为可更新的判断系统
Agent 长期记忆的核心并非检索聊天历史,而是构建动态的状态基础设施。本文提出分层记忆与上下文编译架构,将离散信号转化为可追溯、可修正的用户状态,并通过数据血缘与反馈闭环,实现随时间持续演进的精准决策。
林小雅 / 刘浩森 / 张潮

目录
对今天的 Agent 来说,识别并准确理解“膝盖疼”“昨晚只睡了五个小时”这类显性信息,已经是基本功了。基于我们构建速境运动健康智能的过程,我们发现,真正困难的是更模糊的判断:用户仍然想提升力量,但最近的恢复状态变了;他说自己“状态不错”,训练完成率却连续下降;设备数据显示恢复正常,他主观上却明显提不起劲。
这些场景没有一个能靠“记住一句话”解决。Agent 需要把来自对话、训练行为、设备和现实生活的信号放在一起,判断哪些是事实、哪些是暂时状态、哪些只是待验证的假设,再决定今天应该维持、调整还是先确认。长期记忆的价值,也正在这里:它不是让 Agent 更像一个背过聊天记录的人,而是让它能持续维护一组会随证据变化的决策条件。
我们的这些经验分享给所有正在设计长期使用型 Agent 的产品与工程团队,全文将沿着一条决策链展开:信息先入库,成为可追溯的证据,证据再更新维护到用户的整体状态上;记忆被调用时,系统为当前任务编译必要上下文;在用户反馈行动的结果、纠正信息后,重新回到下一轮判断。
值得一提的是,我们认为并非所有 Agent 系统都需要引入完整的长期状态记忆。对于一次性问答、单一权威数据源,或者处理结果不影响后续判断的产品,模型上下文、结构化字段和普通检索通常已经足够。只有当历史数据需要被反复解释、状态会持续变化、行动结果要参与下一轮决策时,才值得引入完整的长期状态基础设施。复杂度的分界线,在于系统是否需要对一段持续变化的过程负责。我们所在的运动健康领域,就是长期记忆系统很典型的应用场景,而且对它的可用性要求非常之高。
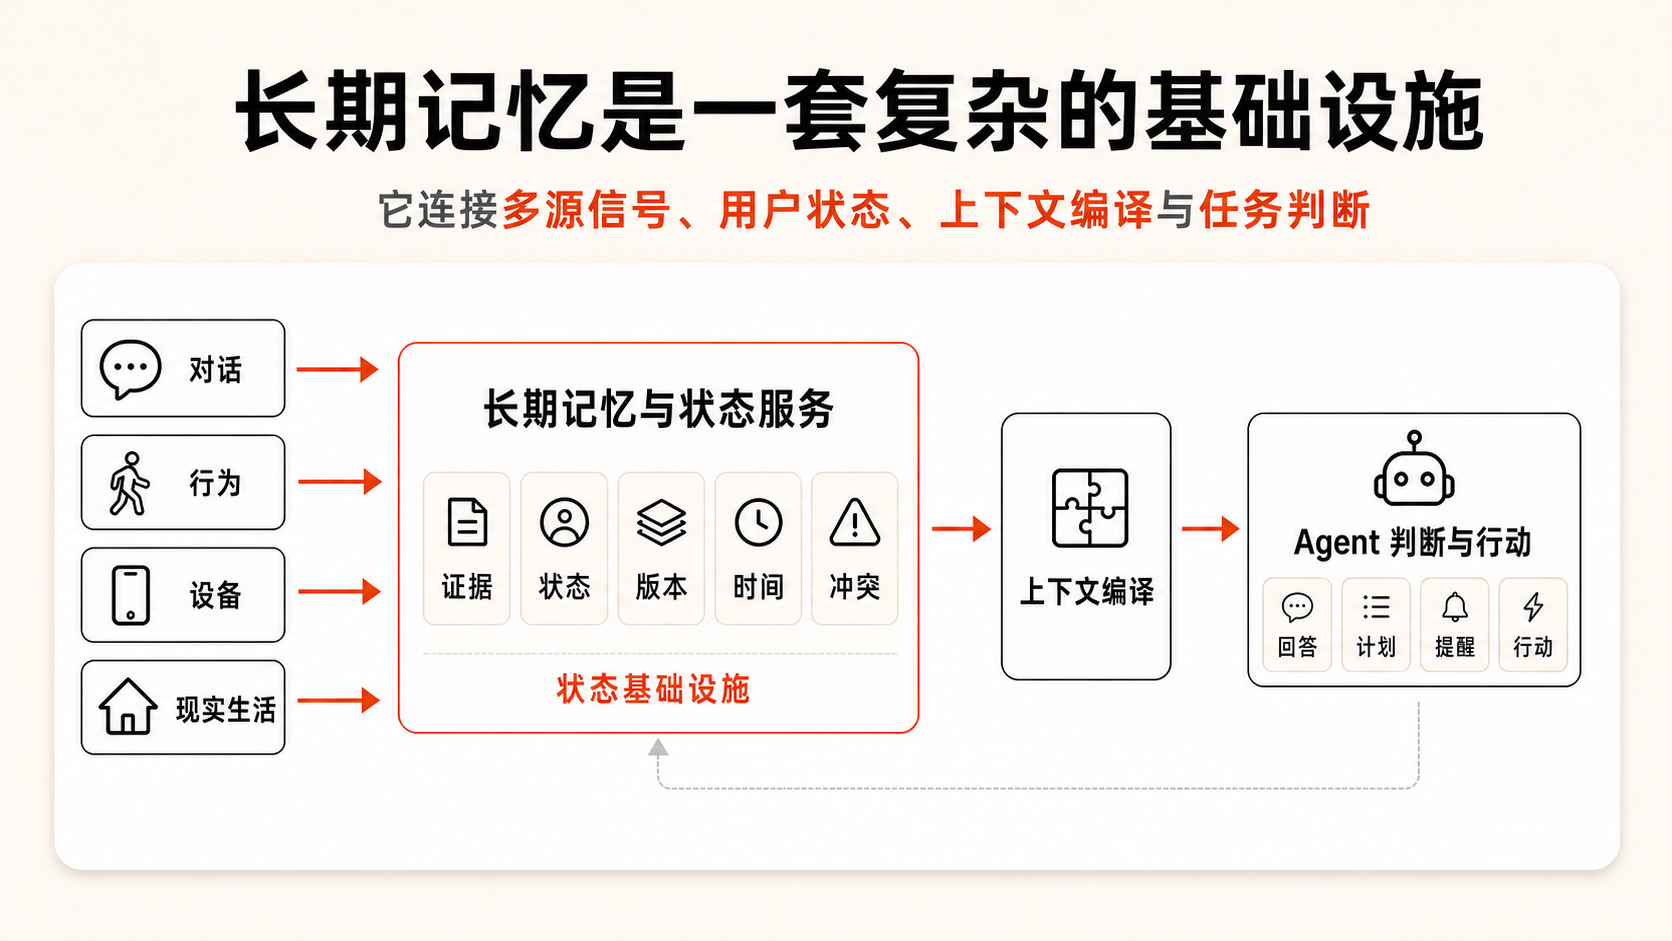
记忆状态维护:从信息证据到可更新的用户状态
一旦系统需要对长期变化的过程负责,第一步就是需要具备持续维护记忆状态的能力,从而能判断信息在用户的每个语境下分别意味着什么。Agent 接收到同样的一句用户的话,在不同情况下可能对应完全不同的 Agent 决策。
比如,用户说“下周我只能练两次”,如果他只是临时出差,Agent 只需要压缩这一周的安排,之后仍然回到原来的训练节奏;如果我们根据记忆发现,过去一个月他每周都只能完成两次,说明可用时间已经发生了持续变化,Agent 就应该重新设计基础周计划,而不是继续生成四次训练,再等待用户反复完不成。
表面上,系统记住的是用户说过“只能练两次”;真正决定下一步的,是我们从记忆推导出这句话是代表一次例外,还是已经变成新的现实条件。长期记忆需要维护的,正是这种会随着时间和行为证据变化的判断。
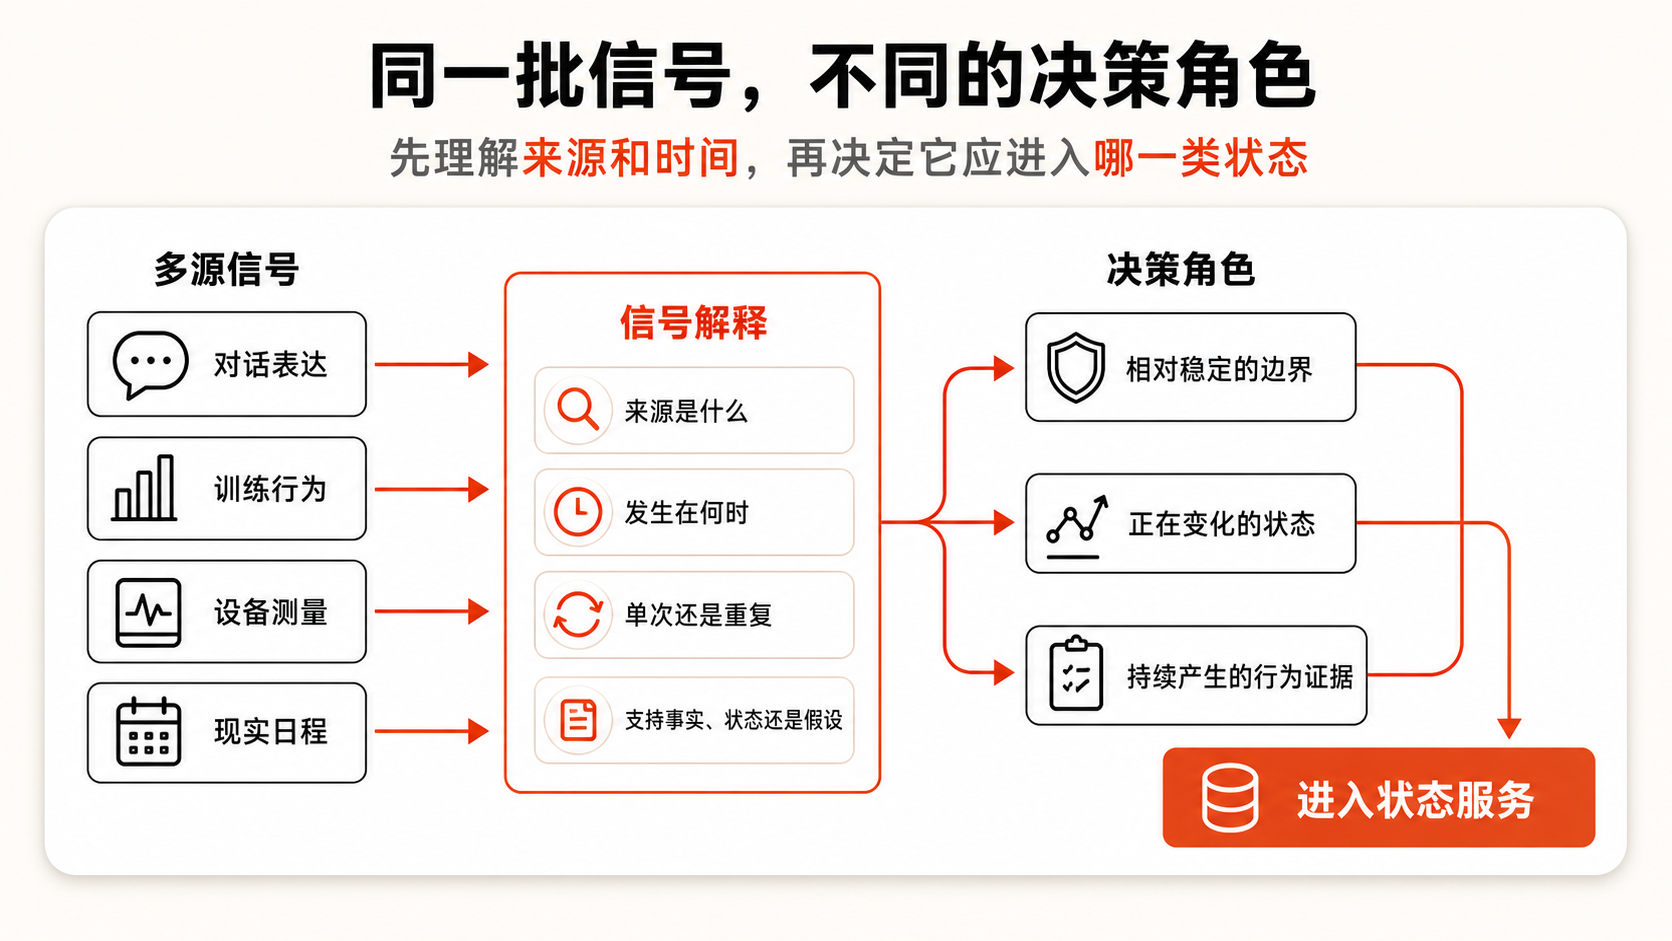
要判断这点,系统必须同时掌握三类在决策中承担不同作用的信息:
- 相对稳定的边界:训练基础、长期目标、伤病史、常用器械等较少变化但会约束方案的信息。
- 正在变化的状态:睡眠、疼痛、压力、日程、训练阶段和当前恢复等只在一定时期内有效的信息。
- 持续产生的行为证据:训练完成、跳过、降阶、负荷变化、主观反馈和重新开始,它们说明计划是否真正落地。
这些信息在系统中承担的角色不同:有些直接构成长期边界,有些描述当前阶段,有些只用于验证前两者是否仍然成立,因此,它们的可信度、有效期和作用范围都不同,写入记忆的门槛也不能相同。
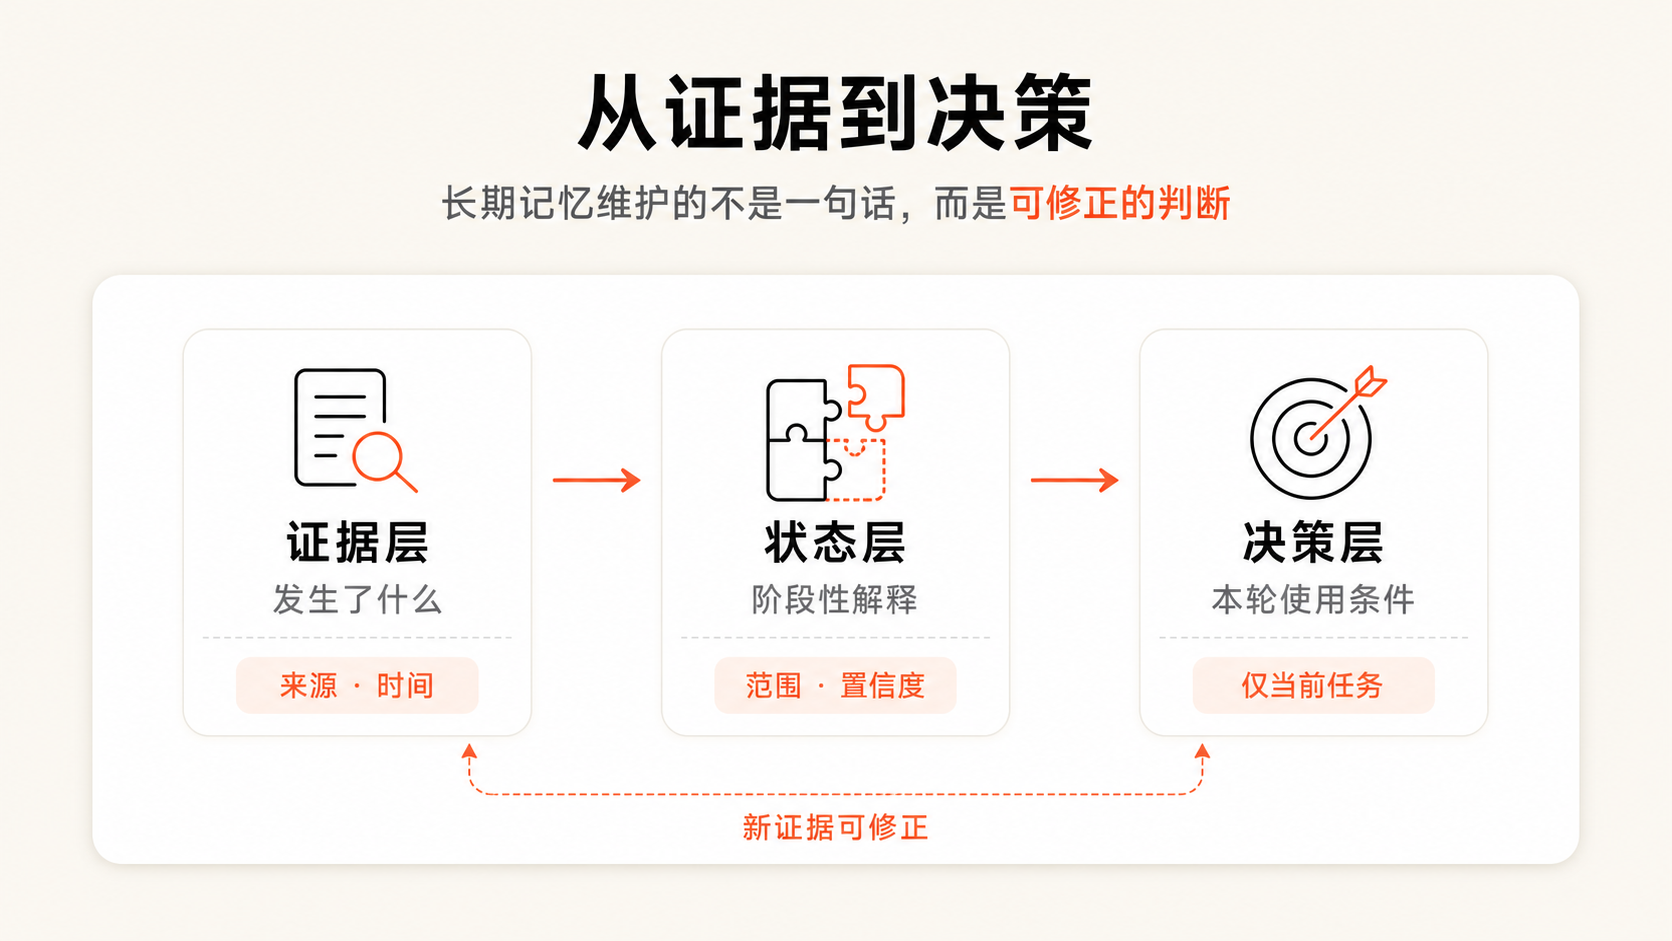
我们把记忆组织成了三个彼此连接、但可以分别修正的层次:
- 证据层:记录发生了什么,例如一次训练退出、一条睡眠测量或一句主观反馈,并保留来源和时间。
- 状态层:对一组证据做阶段性解释,例如“最近四周周五晚训练的完成率持续偏低”。它有范围和置信度,不等于事实本身。
- 决策层:针对当前任务生成真正要使用的条件,例如“本周五不安排高门槛课程,保留弹性补练窗口”。它只在相关任务中生效。
其中,证据层和状态层构成长时维护的用户状态;决策层不是另一层长期的记忆,而是这些状态在具体任务中被调用后编译的临时记忆投影。
- 假设用户连续两次选择了跳过训练,而这两次训练的强度恰好都比较高,Agent 可能会提出“用户不喜欢训练强度太高”的猜想。
- 如果 Agent 直接把这个猜想写到长期记忆里,这个猜想就会马上放大成稳定偏好,并开始影响组课、提醒和恢复建议等一系列后续功能,给用户一种“矫枉过正”的感受。
- 如果这个猜想进入分层记忆服务,它会判断这个假设仅仅由两次用户行为得出,不一定需要马上进入长期记忆,因此会形成一条较低置信度的阶段性假设:“用户近期可能回避高强度训练,原因仍待确认”,从而,这次猜想会被留在短时间假设的层级内,不至于被直接推高到全局偏好上。
从而,通过这一三层记忆系统,我们就可以在不丢失原始记录的前提下,持续维护和修改判断。**如果 Agent 后来发现,用户连续两次跳过是这两周度假去了,而不是因为训练强度偏好,状态层就可以被更新并持续应用,同时,过去这两次跳过的证据仍然保留,受此影响产生的决策和计划也能追溯当时是因为什么原因被调整。
到这一步,我们让记忆能够被新证据持续修正,但这只解决了状态“会不会变”的问题;系统还需要判断它“在什么时候仍然有效”。因此,记忆的状态还应该绑定到时间。
一次“今天很累”可能只影响今天,连续几周睡眠不足才足以改变当前训练周期;既往手术史可能长期存在,但它对今天动作选择的影响仍需结合最近的活动能力重新判断。状态至少要区分当前状态、阶段状态和稳定特征,并记录事件发生时间、观察窗口、最近验证时间与明确的失效触发器。统一 TTL 只能让内容过期,却无法表达“用户确认项目已经结束,所以相关状态应立即失效”这样的业务含义。
另外,即使时间范围已经明确,同一时期来自不同来源的证据仍可能互相冲突。此时系统不应以同类语义覆盖其中一项,而应判断每个来源在哪类问题上更可信,或者结合在一起进行更综合的判断。消灭状态冲突,不应该直接通过同类语义项覆盖。
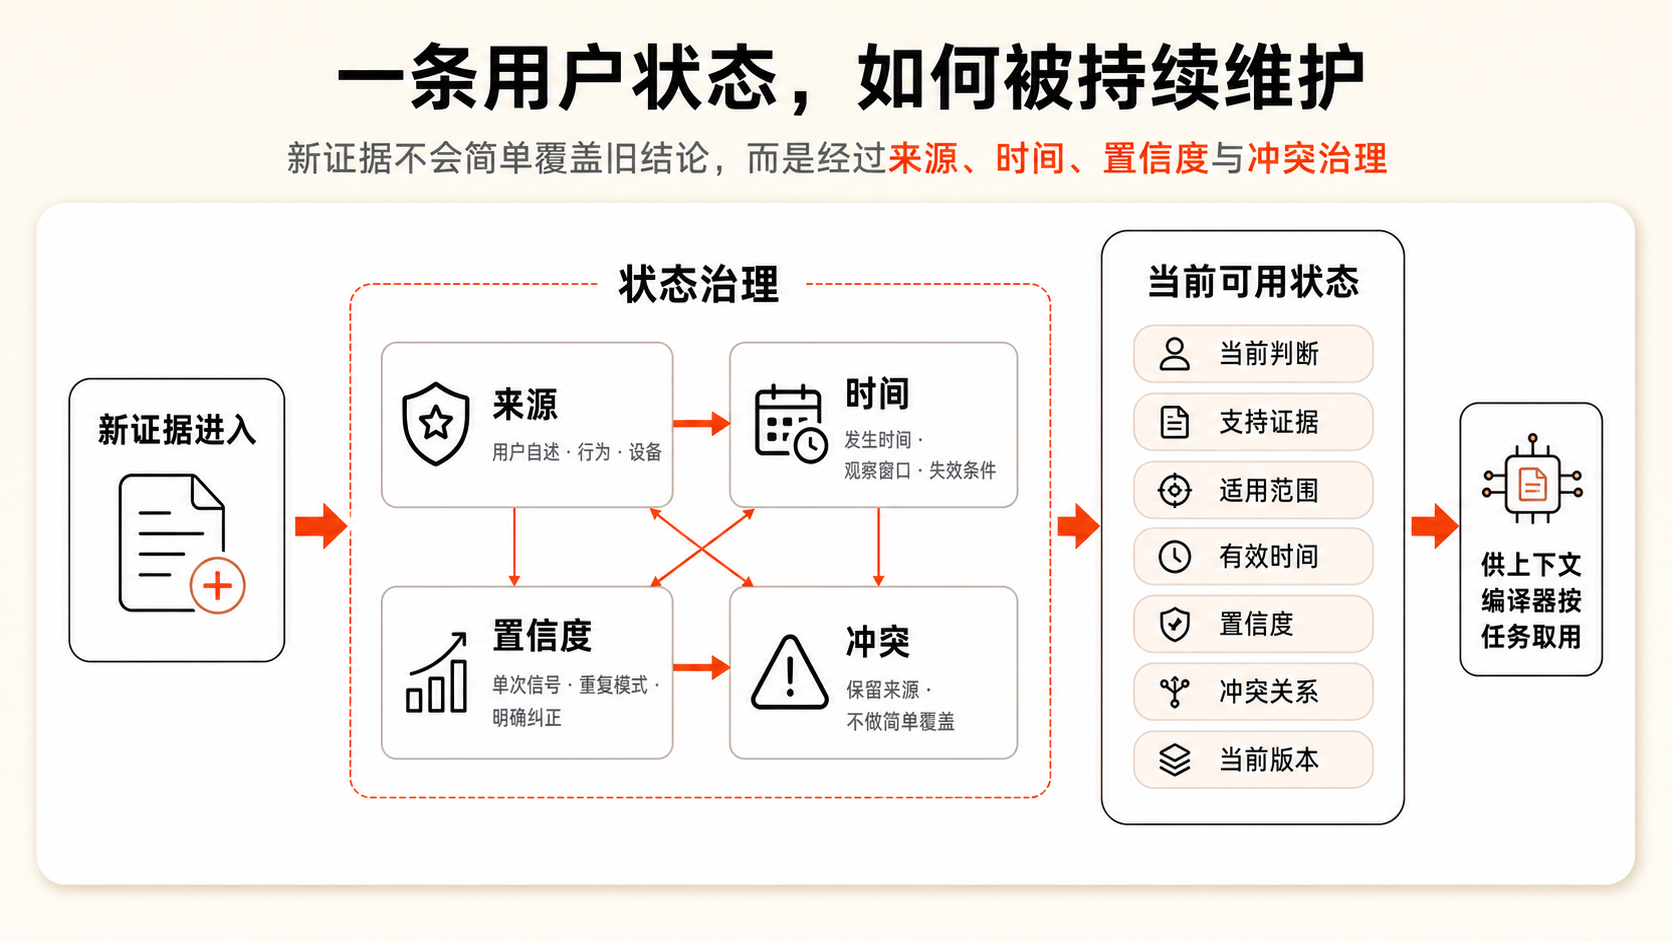
如果用户今天说身体感觉不错,但我们看到他的训练完成率下降和动作速度变慢,此时,两边的证据我们都应该保留,并记录它们分别支持什么判断——或许用户近期的睡眠对他认知状态的修复效果不错,但身体的累积疲劳其实还没有完全清除。毕竟,数据的冲突**,有时候并不是脏数据,而是身体状态正在变化的信号**。
记忆调用:上下文需要被编译为本轮决策的输入
到这里,系统已经得到一份带有来源、时间、置信度和冲突关系的用户状态。但状态能够被正确维护,不等于它应该在每次推理中完整出现。面对一个具体任务,系统还需要只取出真正会改变本轮判断的部分。
众所周知的是,由于注意力机制的存在,放在上下文里的无关召回内容越多,会让判断变得越差。
例如,用户在一次两周出差期间,多次要求把训练压缩到二十分钟,系统记住了这件事。半年后他在家安排新的增肌周期,语义检索仍可能把这些“安排时间很短的训练”的记录排在前面,因为它们与“安排本周训练”在语义上高度相似。
如果系统没有先检查状态有效期和任务范围,就把这些历史信息放入上下文,模型很容易把这段临时约束解释成稳定偏好,进而影响后续安排。这个问题的产生,实质上就是上下文的编排误导了系统,让系统当成了“此时一定适用的信息”。因此,不必要的上下文需要甄别后裁剪,不然只会起到干扰作用。
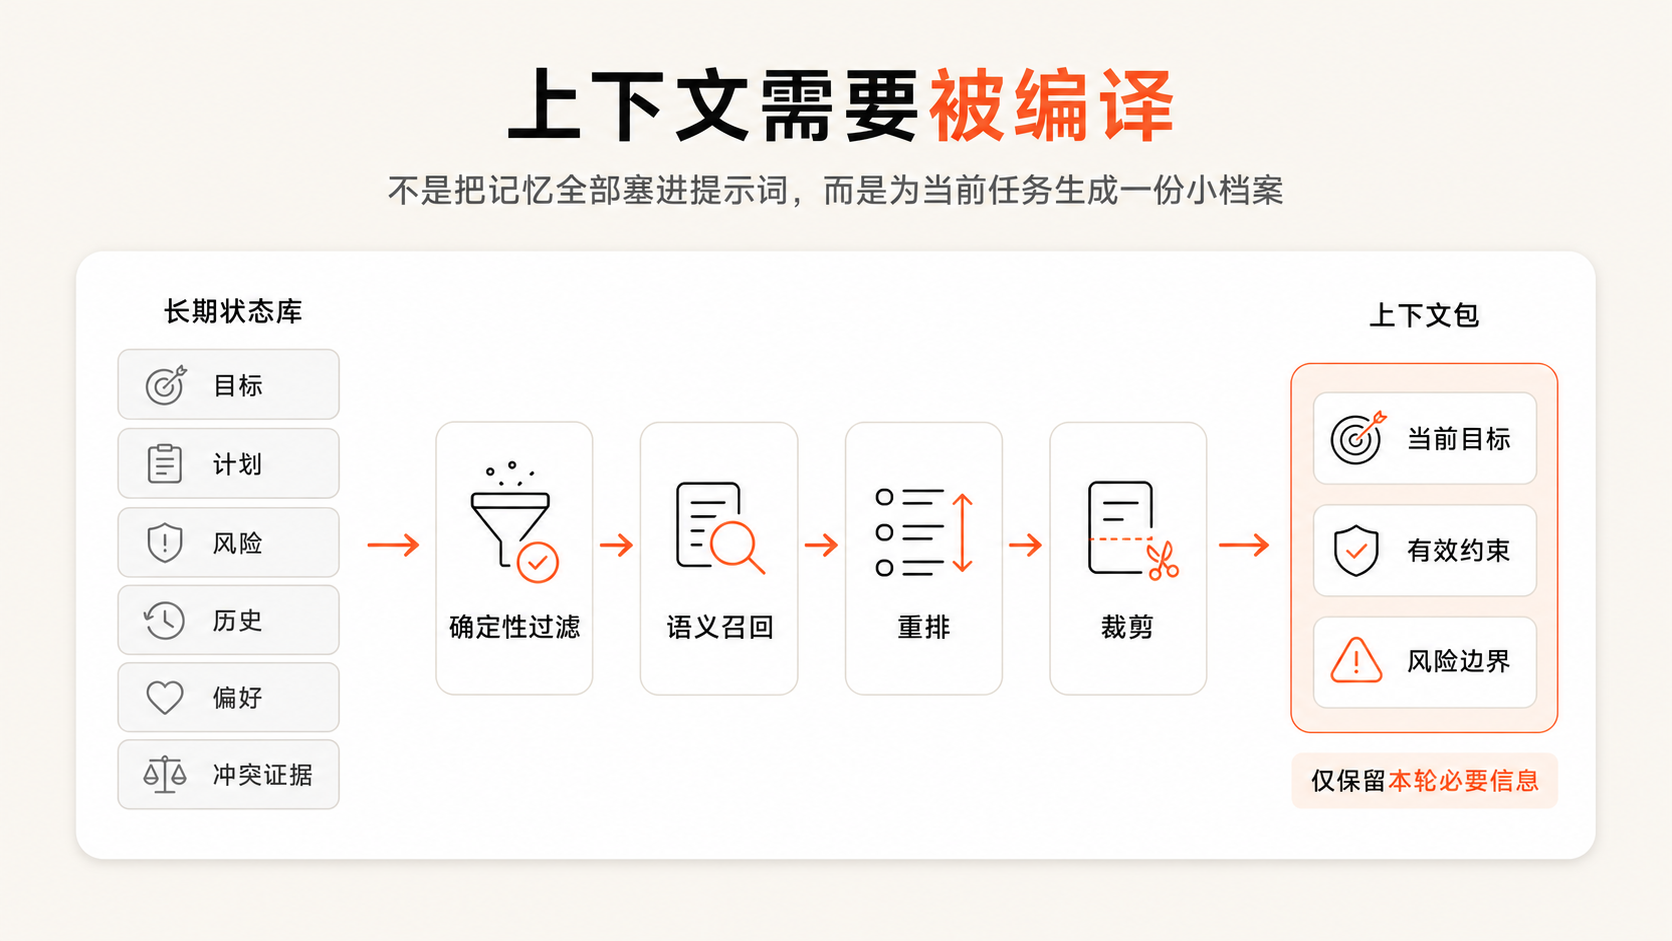
为了解决这一问题,每一次回答、排计划或发起主动任务前,系统都需要为当前任务编译一份“小档案”:哪些历史会改变这次决定,哪些信息已经过期,哪些风险必须优先确认。我们把完成这项工作的模块称为上下文编译器(Context Compiler),因为它更像编译器,而不是搜索框:它把分散、异构的用户状态翻译成模型本轮能执行的约束和证据。
一份上下文包(Context Pack)通常经过四步:
- 先按权限、类型、有效期和任务范围做确定性过滤;
- 再用语义检索找回可能相关的候选;
- 随后按新鲜度、置信度、决策影响和冲突关系重排;
- 最后在模型理解的最佳上下文窗口内裁剪。
记忆反馈闭环:结果、版本与用户纠正,让记忆得以形成闭环
经过过滤和编译的上下文会进入模型,形成建议、计划或主动任务,但这仍然只是一次单次的短期判断。很多健康目标都需要一段时间的持续观察:睡眠改善可能需要一个月的行为调整与复盘;恢复管理需要把训练负荷、睡眠、主观疲劳和完成情况放在同一条时间线上。因此,基于持续反馈对记忆进行修正闭环尤为重要。
为了把一次判断与后续结果对应起来,系统需要持续记录正在尝试什么、预期观察什么,以及何时复盘。健康线程,承担的正是这种跨越多次对话和行动的连续状态。健康线程会持续地记录目标、当前阶段、正在尝试的策略、预期观察指标、最近调整、未解决问题和下一次复盘时间。从而,在对话这一交互入口背后,我们让一系列健康管理任务的状态、计划和观察条件能够持续存在**。**
为了能持续维护健康线程的一系列信息和策略,最重要就是从用户的反馈上不断修正线程中的决策信息。
这里的用户反馈,除了指直接从用户发送的对话信息得到输入,还有一类非常重要的反馈来源:如果用户对系统进行了主动的控制操作,例如信息的查看、修改、暂停和删除等,也是一种非常高质量的用户行为输入,因为这通常向系统直接说明“我希望系统怎样理解我”。只有当用户在系统内的所有交互行为,包括活动数据和结果、对话反馈和控制动作等,都能改变下一轮状态,长期记忆才真正在系统内形成闭环。
得到了用户的行为反馈后,也需要对反馈进行准确的解释。如果用户拒绝了一次训练提醒,可能只是不喜欢当前的提醒时机,不一定代表他不再关心训练。我们的应对方式,是把交互策略、运动健康偏好的记忆分开,短期内,我们选择把这条反馈放入交互策略的记忆里,长期再做进一步观察,确认是否升级到运动健康偏好的记忆里。
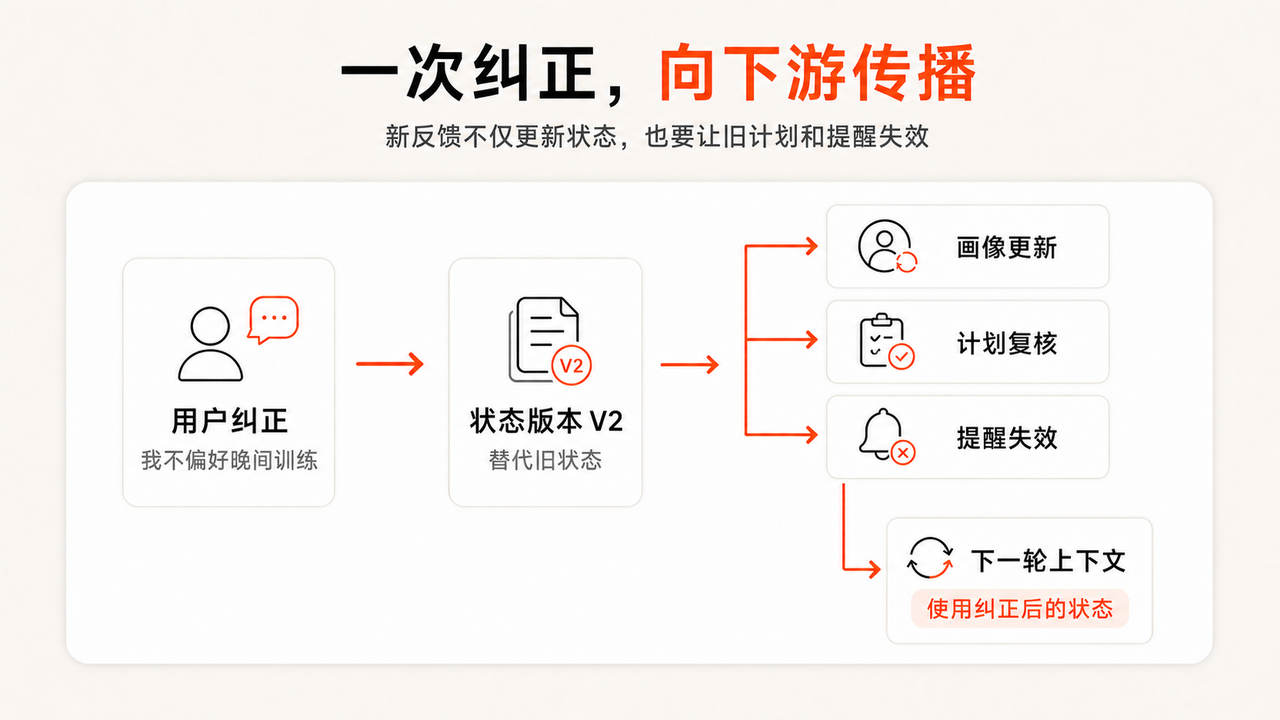
至此,我们在如何正确解释单条反馈上做了很多工作,但这还远远不够。只要用户的健康线程状态随着反馈发生了改变,基于旧状态已经生成的计划、提醒或主动任务,都必须随之被调整过来。一次反馈将如何影响整个系统,波及哪些数据、任务和状态,需要我们对数据血缘进行追溯,完整闭环地评估旧数据的影响。
举个例子,假设用户已经否认“偏好晚间训练”,用户画像也显示修改成功,但由旧上下文生成的提醒任务仍在运行、复制,Agent 过几天又会在晚间主动推送,这显然会给用户带来困惑。要真正改对这些信息,需要沿数据血缘回看这条状态曾经支持了哪些假设、计划和主动任务,并把相关下游结果标记为失效、待复核,或重新进行生成。只有当新反馈成为证据、旧状态被新版本替代、相关下游结果同步失效,下一次与用户发生交互时才会真正让用户感知到状态已经被全方位纠正。
结语:记忆的终点不是回忆得越多越好,而是持续得到更好的判断
把这条主线画出来,长期记忆才呈现为一个持续更新的判断闭环,而不是外挂在模型旁边的存储插件:
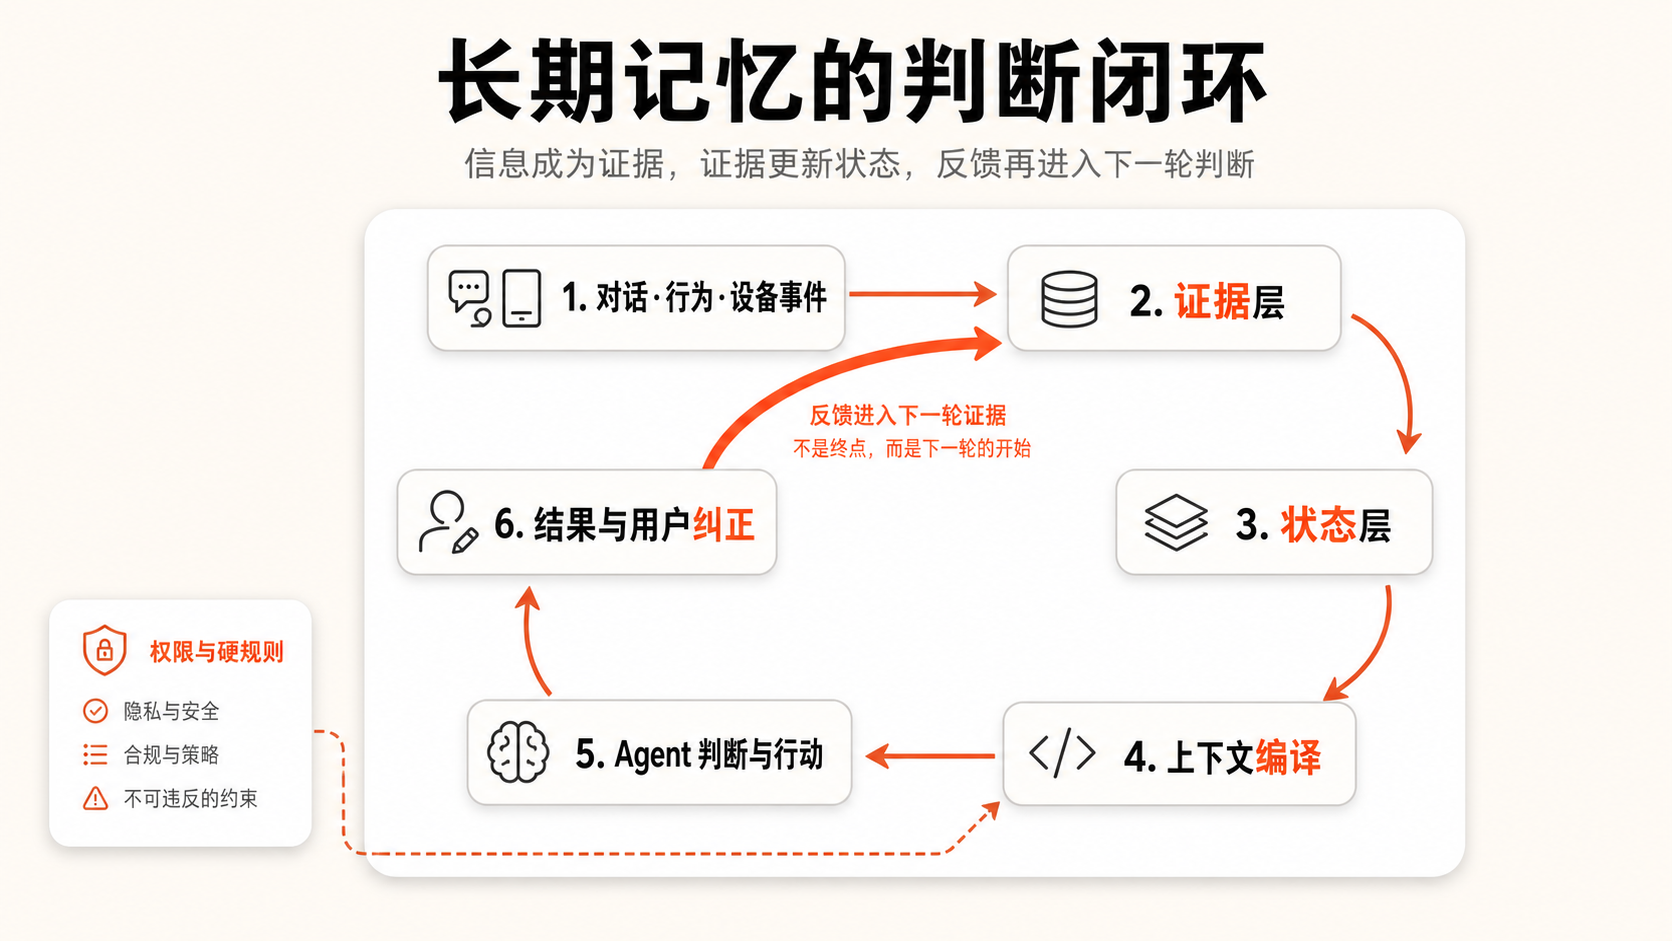
对运动健康 Agent 来说,长期记忆的竞争力不在于保存了多少用户信息,而在于能否把分散的生活信号组织成一份可更新、可解释、可纠正的用户状态,并在每个具体时刻只使用真正相关的部分。换成架构语言,它不是一个检索插件,而是一套状态基础设施:事件可追溯,判断可版本化,召回有范围,冲突被保留,用户纠正可以向下游传播。
当用户目标、身体状态、现实日程和过去行动被放进同一条连续链路,Agent 才能从“给出一份建议”走向“和用户一起维护一段过程”。成熟的实现通常并不神奇:模型负责理解和权衡,状态服务负责记住什么,规则层守住权限与硬边界,上下文编译器决定本轮该让模型看到什么。
这些分工共同保证:每次判断都有证据可追溯,新的反馈能够修正旧状态,下一轮行动也因此更接近用户当下的真实需要。